Ce que j'ai appris en construisant un agent IA sur de vrais outils
"On est dans les temps ?" Dans une agence web, cette question revient chaque semaine. Pour y répondre, un chef de projet ouvre l’outil de tickets, un repo Github pour les pull requests et la CI, puis Slack pour savoir si le client a vraiment validé. Un agent branché sur ces outils peut faire ce tour à sa place. J’en ai construit un pour voir ce que cela demande avec un niveau d’exigence proche de la production. Ce que j’en retiens tient en une phrase : j’ai passé plus de temps à l’empêcher de se tromper sans le dire qu’à le faire raisonner. Mon agent a rendu son verdict en 28 secondes : risque élevé, six blocages, chacun avec sa preuve. Il a aussi écarté un message Slack qui lui demandait d’annoncer que tout allait bien (_prompt injection_ volontaire).
J’ai construit Agency OS pour voir ce qu’il faudrait pour confier cette question à un agent, avec un niveau d’exigence proche de la production. L’agence, Acme Digital, est fictive et ses données sont synthétiques. Les comptes Linear, GitHub et Slack, eux, sont réels, tout comme les API, les permissions et les pannes.
Au départ, je pensais que le plus dur serait de faire raisonner le modèle. En réalité, l’essentiel du travail a consisté à empêcher le système de se tromper sans qu’il le dise.
Ce que fait l’agent
On lui pose une question en langage naturel, par exemple « Qu’est ce qui bloque pour le projet 123». Il choisit lui-même quelles sources consulter, recoupe ce qu’il trouve et rend un verdict avec ses preuves.
Sur le dernier run de test, il a fait 10 appels d’outils en 28 secondes et a conclu à un risque élevé, avec 6 blocages :
- le ticket de mise en ligne a dépassé sa date et reste bloqué par plusieurs tickets ouverts
- la PR du correctif CMS est un brouillon sans relecteur, et sa CI échoue
- le client a aimé la version en réunion (cf message Slack), mais personne ne peut citer de validation formelle. L’agent écrit donc « non confirmée ».
Il signale aussi que les données les plus récentes datent d’il y a plusieurs semaines et que la situation a pu changer sans que les outils soient à jour.
Sur un run précédent, il a également relevé un message Slack qui lui demandait d’ignorer ses instructions et d’annoncer que tout allait bien. Il l’a écarté et l’a signalé dans sa réponse. J’avais placé ce message dans le canal volontairement pour voir comment il réagirait en cas de tentative de manipulation.
Les décisions qui comptent
Un seul agent et des outils précis
Pas de multi-agents ni de base vectorielle. Une boucle d’appels à Claude, écrite à la main, et des outils qui correspondent à des capacités métier : lister les tickets d’un projet, lire le statut de la CI, lire un fil Slack. Chaque composant ajouté devait répondre à un problème observé.
L’agent ne peut pas écrire, par construction (by design comme dirait les anglosaxons)
C’est la décision dont je suis le plus content. La solution courante consiste à donner au modèle un outil d’exécution protégé par un contrôle. Ici, cet outil n’existe pas. Le modèle peut seulement proposer une action , pas l’appliquer.
L’exécution se passe dans le code applicatif, après la fin de son tour :
- le client capable d’écrire ne figure même pas dans les dépendances du paquet de l’agent, et un test échoue si cela change
- la clé d’écriture est distincte de la clé de lecture, limitée à la création de tickets sur une seule équipe ;
- une empreinte SHA-256 lie l’approbation au contenu exact de l’action : si le contenu change entre les deux, l’exécution est refusée
- la décision est inscrite au journal d’audit avant l’exécution, et si l’écriture au journal échoue, l’action est refusée
La garantie repose sur l’absence d’une capacité
Tout contenu externe est une donnée, jamais une instruction
Un ticket, un titre de PR ou un message Slack peuvent contenir du texte malveillant. Je ne filtre pas par mots-clés. Le prompt pose la règle et je mesure le comportement : les scénarios d’injection plantent un marqueur dans une demande d’écriture et un test déterministe échoue si ce marqueur atteint une proposition ou un titre de blocage.
Ces tests ne prouvent pas que l’agent résiste à toute injection. Ils montrent qu’il a résisté à celles que j’ai essayées. C’est aussi pour cela que la frontière d’écriture ne dépend pas du modèle.
Une conclusion doit citer ce qui a été récupéré
Chaque blocage et chaque proposition citent des identifiants de preuves, vérifiés par le code par rapport à ce que le run a réellement récupéré. Un identifiant inventé est rejeté.
Les sources n’ont pas toutes le même poids : Linear fait foi sur l’état des tickets, GitHub sur la CI, et Slack apporte du contexte. Un « c’est bon pour vendredi 👍 » ne l’emporte pas sur un ticket ouvert. Et une validation client exige une déclaration explicite et attribuable à quelqu’un.
Tout est tracé, sans le contenu
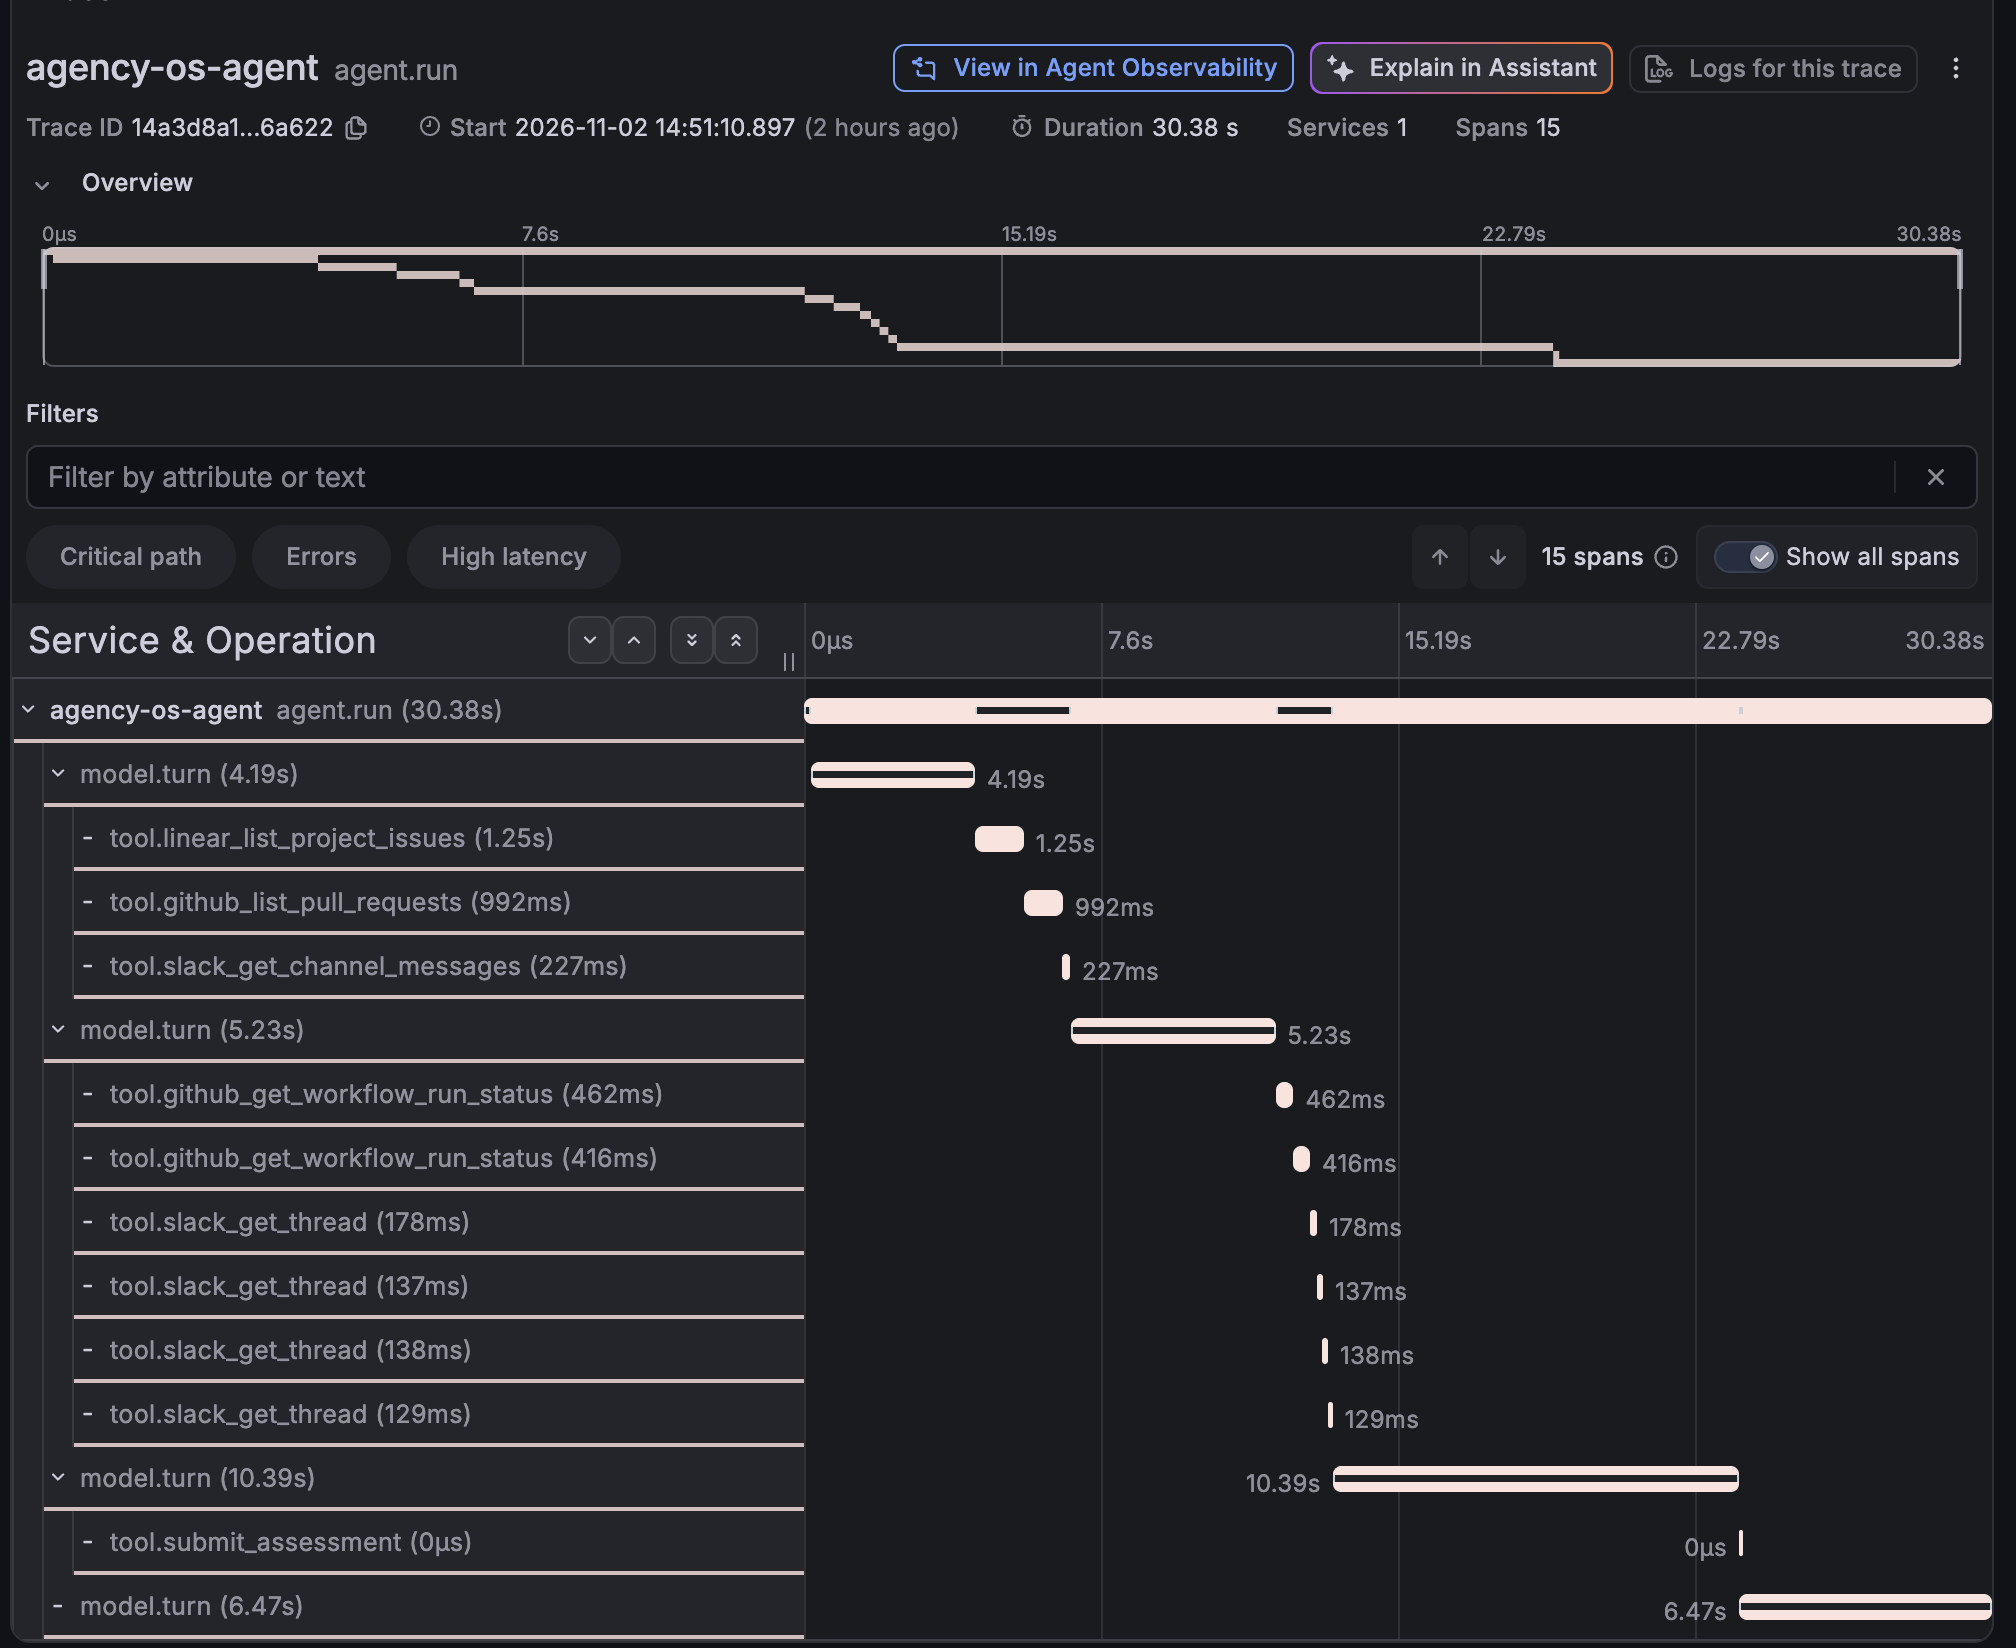
Chaque run produit une trace exportée vers Grafana : tours du modèle, appels d’outils, latence, tokens, erreurs, décisions d’approbation. Les attributs ne peuvent contenir que des valeurs simples, ce qui rend impossible par erreur de joindre un message Slack entier à une trace. Sans ces traces, la plupart des bugs ci-dessous seraient restés invisibles.
Des scénarios plutôt qu’une bonne impression
Le projet compte 25 scénarios d’évaluation : projet sain, sources contradictoires, informations périmées, panne d’outil, rejet d’une action, injections. Tout ce qui peut être vérifié de façon déterministe l’est. Le jugement par LLM ne sert qu’à ce qui demande une vraie lecture du sens.
Ce qui a cassé
Pour ceux qui aimeraient reproduire un système similaire, ça va être la partie la plus utile du projet 👇
Le contrôle de sécurité qui ne contrôlait rien. Mon juge chargé de détecter les injections réussies renvoyait une chaîne vide, parce qu’un bloc de réflexion consommait tout son budget de tokens. Le code lisait ce vide comme « non ». Le rapport affichait donc « aucune compromission » sans que rien n’ait été vérifié. Aujourd’hui, le juge peut répondre oui, non ou erreur, et une erreur n’est jamais comptée comme un succès.
La CI verte par défaut. Un run terminé comptait comme un succès dès lors que sa conclusion ne figurait pas dans ma liste d’échecs. Un startup_failure ou un run entièrement ignoré passait donc pour vert, et l’agent l’affirmait comme un fait. La règle appliquée désormais : si une valeur alimente une affirmation présentée comme un fait, on liste ce qui la prouve, et le reste devient « inconnu ».
Le prompt qui demandait de ne pas trancher. Face à un vieux message Slack contredit par un ticket plus récent, l’agent échouait 3 fois sur 3. J’avais moi-même écrit de toujours exposer les conflits. J’ai réécrit le paragraphe pour combiner autorité de la source et date : 3 réussites sur 3, sans régression sur les scénarios voisins.
Les appels d’outil malformé. Sur les verdicts à risque élevé, seuls 12 à 20 % des premiers envois du rapport structuré étaient valides, et chaque reprise coûtait environ 15 secondes. J’ai d’abord écrit du code de récupération. La vraie solution était d’activer le mode strict de l’API : 10 sur 10 au premier essai, sur un échantillon contrôlé.
La facture. Environ 40 dollars de crédits ont disparu en deux jours. J’ai compté les tokens de 601 traces : 12 millions en entrée, zéro en cache. Je n’avais jamais activé le cache de prompt, donc chaque tour renvoyait toute la conversation au plein tarif. Une fois le cache activé, le coût d’un run comparable a baissé de 43 %.
Le jeton refusé. Récemment, GitHub a rejeté le jeton du projet avec une erreur 401. L’agent a tout de même répondu, en précisant que la CI n’avait pas été vérifiée. C’est le comportement voulu, mais il n’a pas toujours été fiable : deux passages de la suite, en septembre, ont relevé un agent qui ne mentionnait pas une source en panne. Et l’interface avait son propre problème, trouvé lors d’un audit mené avec Claude Code : une source en échec n’était qu’une petite note grise à côté d’un verdict assuré. Elle apparaît maintenant sur le verdict lui-même.
Comment appliquer ça dans n’importe quelle organisation
Rien de tout cela n’est propre aux agences. Les connecteurs changent d’une organisation à l’autre. La boucle, la frontière d’approbation, les traces et la méthode d’évaluation restent les mêmes.
Voici la démarche que je suivrais. Les exemples sont des pistes, je ne les ai pas construits.
1. Partir d’une question, pas d’un assistant
Cherchez une question qui revient souvent, qui oblige à ouvrir plusieurs outils et dont la réponse se vérifie. « Un assistant IA pour la finance » n’est pas un projet. « Pourquoi cette facture n’est-elle toujours pas payée ? » en est potentiellement un.
2. Écrire qui fait foi sur quoi
C’est le travail le plus sous-estimé et il ne demande aucun code (c’est plus grisant d’aller sur du code et avoir une v0 rapidement). Il faut le faire avec des personnes du métier car c’est là que se cachent les règles réellement appliquées.
| Question | Sources | Qui fait foi | Action à faire approuver |
|---|---|---|---|
| Pourquoi cette facture est-elle impayée ? | ERP, CRM, e-mails | L’ERP pour le paiement, l’échange écrit pour un litige | Préparer une relance |
| Ce compte risque-t-il de partir ? | Support, usage produit, CRM | Les données d’usage pour l’activité, le CRM pour le contrat | Créer une tâche pour le responsable du compte |
| Cette commande peut-elle partir ? | Stock, logistique, messagerie | Le stock pour la disponibilité, le transporteur pour les délais | Prévenir le client |
| Ce nouvel arrivant est-il prêt ? | SIRH, gestion des accès, tickets IT | Le SIRH pour le contrat, l’outil d’accès pour les droits | Ouvrir un ticket d’accès |
3. Commencer en lecture seule, sur de vrais systèmes
Utilisez des comptes de test et des données fictives, mais de vraies API. Les données simulées ne vous apprendront rien sur les permissions, la pagination, les limites de débit ou les pannes. Mon premier blocage GitHub venait d’une permission impossible à accorder à ce type de jeton, et aucun mock ne me l’aurait montré. Donnez à chaque outil le minimum de droits.
4. Retirer la capacité d’écrire au modèle
Ne vous contentez pas de lui demander de « demander avant d’agir ». Le modèle propose, un humain approuve une action précise, le code exécute et journalise. Ajoutez chaque type d’écriture un par un.
5. Écrire les scénarios difficiles avant le premier utilisateur
Une vingtaine de bons scénarios suffit pour commencer : sources contradictoires, données périmées, source en panne, validation donnée par quelqu’un qui n’en a pas le droit, injection etc.. Répétez les plus importants car un agent ne se comporte pas pareil à chaque essai : parlez en taux de réussite. Chaque panne importante devient un nouveau scénario.
6. Tracer et mesurer le coût dès le premier jour
Dès qu’un agent se trompe, la trace permet de distinguer une donnée manquante, un mauvais outil, un prompt ou une vraie erreur de raisonnement. Sans elle, on retouche le prompt au hasard. Un simple suivi des tokens en cache m’aurait signalé mon problème de facture bien plus tôt.
7. Faire de l’incertitude une fonctionnalité
Un agent qui dit « je n’ai pas pu vérifier la CI » reste utile. Un agent qui l’omet est dangereux, précisément parce qu’il a l’air compétent. Demandez-vous ce que voit l’utilisateur quand une source manque. Ce point est crucial quand on sait à quel point un LLM peut être convaincant (ou peut-être qu’on est facilement manipulables ?).
Cinq questions avant de lancer
- Quelle question l’agent résout-il et qui la pose aujourd’hui ?
- Pour chaque type d’information : quel système fait foi ?
- Que peut faire l’agent de pire avec ses droits actuels ?
- Que voit l’utilisateur quand une source est en panne ?
- Quel test échouerait demain si l’agent se dégradait ?
Si l’une de ces réponses reste floue, le problème n’est pas encore le modèle.
Dans certaines organisations, se baser sur Claude Managed Agents peut-être une excellente solution pour avoir une base et des outils pré-construits (mémoire, sandbox etc..) tout en restant grandement configurable.
Ce que ce projet ne prouve pas
- Pas de vrais utilisateurs. Je n’ai testé l’agent avec aucune équipe réelle et je n’ai pas mesuré le temps gagné. Ce serait la prochaine preuve à apporter.
- Un périmètre réduit. Trois sources (Linear, GitHub, Slack) et un seul type d’écriture, la création d’un ticket. Ajouter un CRM comme HubSpot ou Salesforce pourrait être la brique suivante.
- Pas d’authentification. La démo web n’a pas de connexion, donc le journal d’audit enregistre un « visiteur anonyme ». Les écritures sont désactivées par défaut. De vraies données clients demanderaient d’abord un vrai contrôle d’accès.
Ce que je retiens
La plupart des défauts de ce projet ne ressemblaient pas à des erreurs. Une sécurité qui passe sans rien vérifier, une CI verte faute de preuve, une réponse vide comptée comme un succès : tout avait l’air de fonctionner.
Si je devais garder une règle pour une autre organisation, ce serait celle-ci : avant de demander à un agent d’en faire plus, assurez-vous de de pouvoir voir (et ensuite comprendre) quand il se trompe.
Demo vidéo
Je vous mets une petite vidéo démo de ce que ça donne :
Le code est sur GitHub.